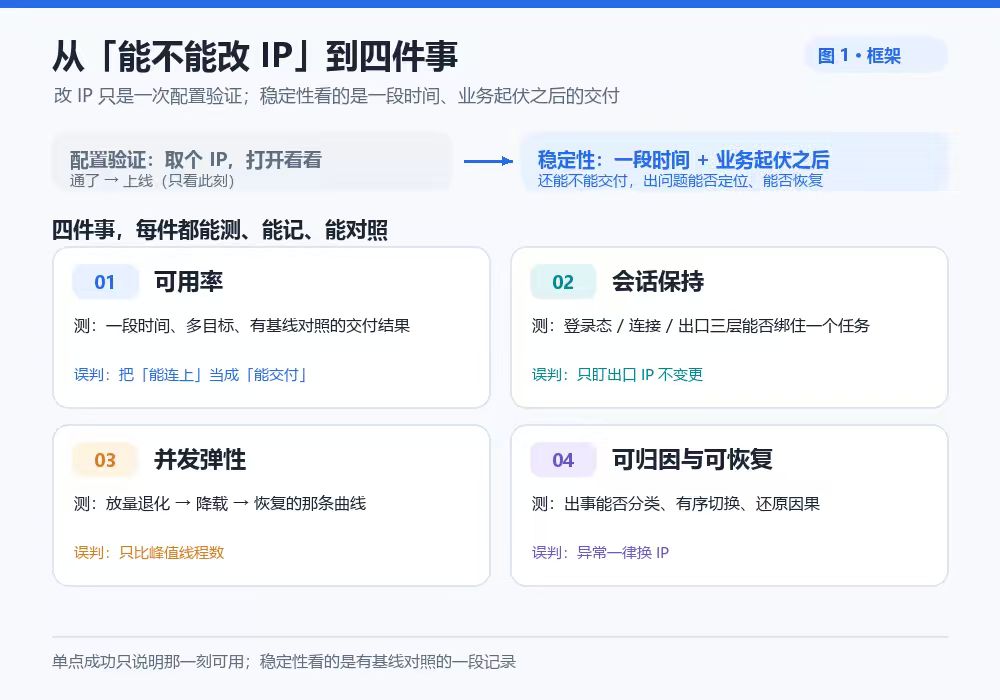
接入代理时,最常见的验收方式是这样:取一个 IP,配上,打开目标页面——能开,通了,上线。
结果跑了一阵子,问题才慢慢冒出来:白天好好的,晚间开始变慢;一批任务跑着跑着会话就掉了;并发一加压,超时和重试成片出现;出了异常,翻遍日志也说不清是 IP 失效、目标站限流,还是自己这边配置没跟上。
这些都不是"能不能改 IP"能提前暴露的。改 IP 只是一次性的配置验证,而稳定性问的是另一件事:在一段时间里、在业务起伏之后,这条链路还能不能稳定交付,出了问题能不能说清、能不能恢复。
这篇不聊"哪家更快、IP 更多",只把上线前真正该测的四件事拆开,每件都给到能照着跑的测法和判断口径。
一、可用率:把"能连上"换成"一直能交付"
第一件,也是最容易被"能打开页面"糊弄过去的一件。
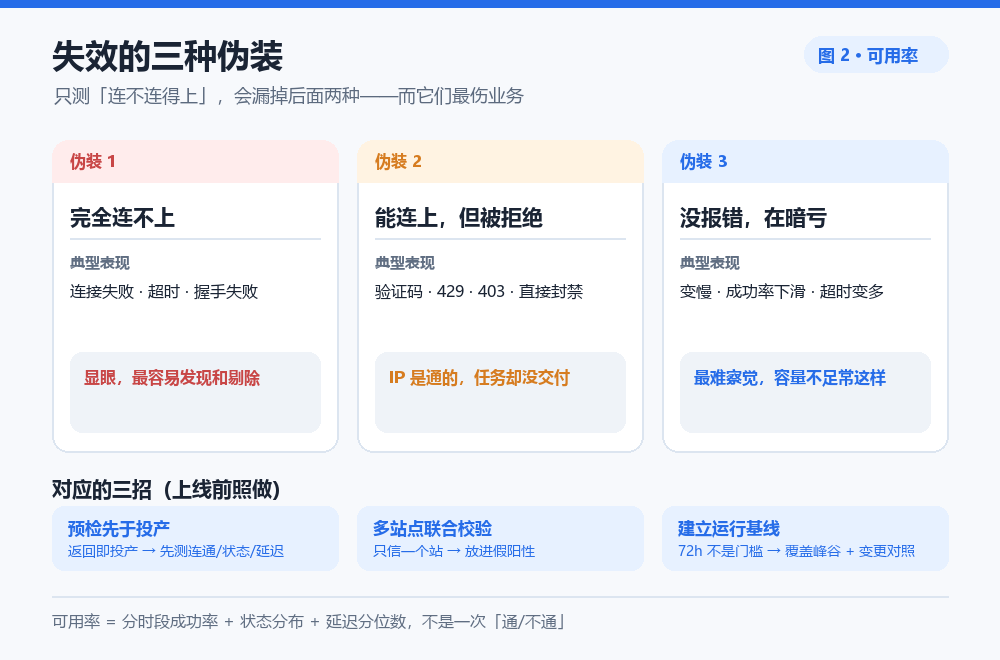
多数人以为 IP 失效就是连不上。其实它至少有三种伪装,只测第一种,会漏掉后面两种:
- 完全连不上——最显眼,也最容易剔除;
- 能连上,但被拒绝——目标站返回验证码、429、403,甚至直接封禁。IP 是通的,任务却没交付;
- 看着没报错,其实在暗亏——出口池容量不足时,往往不是显式失败,而是任务变慢、成功率悄悄下滑、超时变多。这种最难察觉,却最伤业务。
所以可用率不能用一个"通/不通"来记。真正靠谱的做法有三步:
预检先于投产。 接口返回的 IP 不要直接丢进生产,先按真实业务的协议、地域做一轮连通性、状态码和延迟检测,把已经失效的节点剔掉。注意预检本身也发请求,高频空转会触发检测接口自己的限流,别把它当压测跑。
多站点联合校验。 只拿一个校验站(比如某搜索首页)判定可用,会放进一批"只对校验站可用"的假阳性 IP。同时请求多个、且覆盖真实业务协议与地域的目标,才能把这类假阳性排掉。代价是校验变慢、短效 IP 可能在校验完成前就过期,这个取舍要按你的 IP 类型来定。
用运行基线,而不是固定时长。 有人拿"72 小时不掉线"当门槛,但它不是通用标准,更不是"不掉线"的承诺。更有用的是建一条运行基线:覆盖你真实的业务高峰、低谷和会话周期,记录配置版本、观察窗口、预期结果类别和脱敏后的证据索引。基线里不要存完整代理地址、账号密码、Cookie 或业务载荷——记任务别名、时间和脱敏错误摘要,足够支撑排查和交接。
一句话:单点成功只说明那一刻可用;可用率看的是一段时间、多个目标、有基线对照的交付结果。
二、会话保持:稳的不是 IP 不变,是绑定关系不散
第二件,最容易被"固定 IP"这个词带偏。
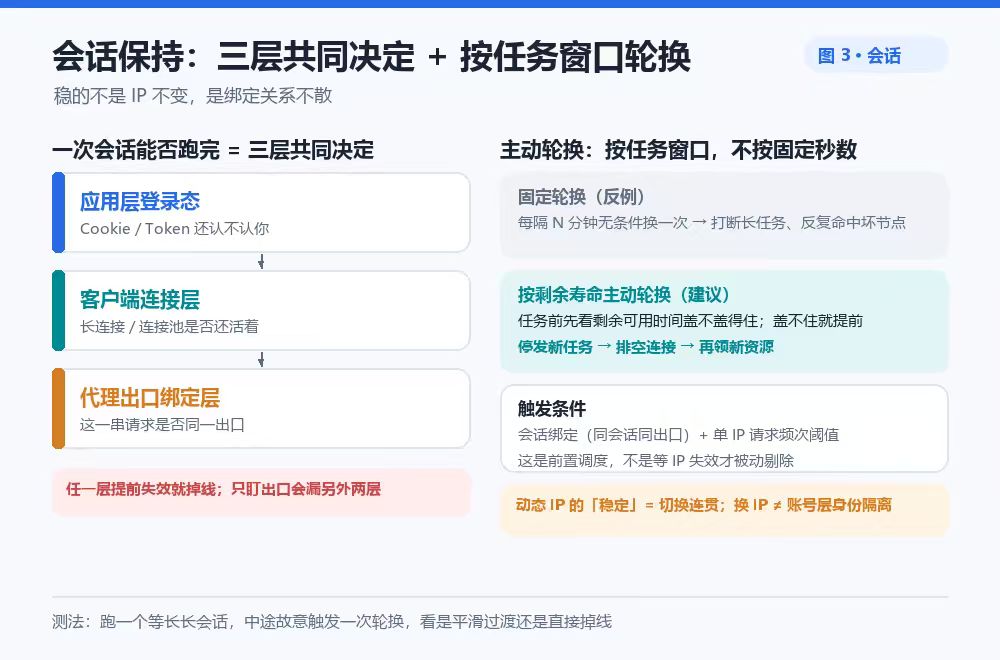
很多人把会话稳不稳,等同于"出口 IP 是不是一直不变"。但一次会话能不能跑完,是三层共同决定的:
- 应用层登录态——Cookie / Token 还认不认你;
- 客户端连接层——连接池、长连接是不是还活着;
- 代理出口绑定层——这一串请求是不是还从同一个出口出去。
三层里任何一层提前失效,任务都会中途掉线。只盯住"出口 IP 没变",会漏掉 Cookie 过期、连接池被回收这类问题;反过来,把三层的问题全归到代理出口,也会误判。
这里要先纠正一个常见误解:动态 IP 的"稳定",从来不是 IP 一成不变,而是它在切换过程中能提供连贯的服务和连接。 换 IP 本身,也切断不了账号层的身份关联——Cookie、设备指纹、账号行为还在,光换出口不构成身份隔离。
真正该做的是按任务窗口管理轮换:
- 看剩余寿命,不看固定秒数。 任务开始前先判断当前代理的剩余可用时间,预计盖不住这次任务,就提前停发新任务、排空连接、再领新资源——这叫主动轮换,而不是每隔固定几分钟无条件换一次。
- 按会话绑定 + 频次阈值触发。 同一业务会话内保持同一出口,否则登录态和状态型请求会断;单 IP 的请求量到阈值再切。这是前置调度,不是等 IP 失效了才被动剔除。
- 登录态、浏览器自动化要绑节点。 需要 Cookie 的采集、浏览器多上下文,都应以会话为单位把节点和上下文绑定;逐页随机换 IP,只会反复打断登录态、让失败重试一次次命中同一个坏节点。
怎么测: 跑一个和你真实任务等长的长会话,全程盯住出口、认证、连接三层是否按预期保持;在任务中途故意触发一次轮换,看会话是平滑过渡还是直接掉线。掉线了,再逐层排除是哪一层先失效。
三、并发弹性:放量时稳得住,退下来回得快
第三件,是压测时最容易看错指标的一件。
"最大能开多少线程"是个很诱人的数字,但它说明不了弹性。弹性并发看的不是某一刻能把线程开到多大,而是业务流量升高、目标站变慢、失败重试变多时,链路能不能稳定扩容、平滑降速、快速恢复。 峰值高、一放量就崩、降载半天回不来,这不是弹性。
两个判断要点:
并发是匹配题,不是越大越好。 你的代理承载量,要和自己的出口容量、目标站的限流阈值找一个双方都能接受的平衡点。并发拉满、把目标站惹毛,只会换来更多 429 和封禁,有效吞吐反而下降。
容量不足常常不报错。 前面说过,出口池或自有出口 NAT 的连接数到顶时,表现是变慢、成功率下滑、超时增多,而不是一句"容量不足"。这里有个很实用的分层判断:低并发正常、放量后集中超时,且带宽还没到顶——先去查自有出口 NAT 网关的连接数容量,别急着判定代理节点失效。NAT 指标正常而代理入口仍失败,才往代理侧鉴权或节点健康上找。
顺带两个坑:超时时间设得过长,线程或进程会被长时间占住、无法释放,最后整个程序卡住;同一网段的 IP 同时用太多,一次风控判定就可能把整段一起拉黑,并发上限要按网段也设一道。
怎么测: 做阶梯加压——从低并发起步,逐级加,每级记录成功率、P95 延迟、超时和重试量,找到开始退化的那个点;然后降载,看多久能回到基线。一条链路值不值,看的是这条"上去—退化—退下来—恢复"的曲线,不是最高那一个点。
四、可归因与可恢复:出事能定位,才谈得上稳
第四件,决定了前面三件出了问题之后,你是"能修",还是"只能猜"。
不是所有请求异常都是 IP 失效。 网络波动、目标站超时、代理失效,三者的表现长得非常像。不分类就一律换 IP、剔节点,会把还能用的资源误删掉,也永远查不到真因。分级重试要区分网络波动、站点限流、服务异常,只重试可恢复的类型,避免无效循环把代理资源和时间一起烧掉。
真正可维护的策略,是先判断失败落在哪一层——代理链路、目标站响应,还是页面解析——再决定是继续、切换、冷却,还是停任务。
主备切换也一样,目标不是连接一报错就立刻换地址,而是在主隧道确实不可用时,把新请求有序转到已验证的备用隧道,同时保护正在执行的会话,恢复后还要避免来回横跳。频繁横跳本身就会制造新的不稳定。
还有个容易踩的归因陷阱:账号异常和出口变更时间相近,不能单独证明是出口导致的。 发生时间挨得近,不等于有因果。稳定性问题难定位,往往不是日志太少,而是计划内的变更和异常事件混在了一起:某次客户端升级、某次配置改动、某次环境迁移,和某次波动恰好撞上,就谁也说不清了。把"变更记录"和"异常事件"分成两条时间线来记,排查时才对得上。
怎么测: 主动做一次故障演练——人为让主链路不可用、制造一次目标站限流、改一项配置,看系统能不能正确分类、能不能只重试该重试的、主备有没有序、恢复花了多久,以及事后能不能从两条时间线里还原出因果。能复盘,才算可恢复。
五、一张可复制的上线验收清单
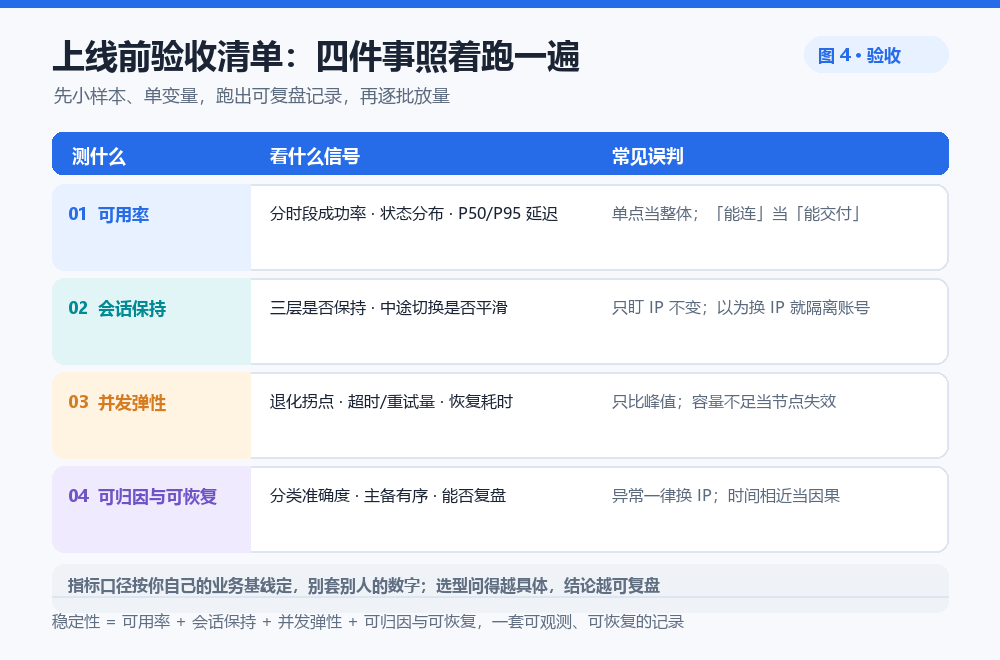
把四件事收成一张表,上线前照着跑一遍,比"取个 IP 打开看看"靠谱得多。指标口径按你自己的业务基线来定,别套别人的数字。
| 测什么 | 关键动作 | 看什么信号 | 常见误判 |
|---|---|---|---|
| 可用率 | 预检 + 多站点联合校验 + 运行基线 | 分时段成功率、状态分布、P50/P95 延迟 | 把"能连上"当成"能交付";拿单点数值外推 |
| 会话保持 | 等长长会话 + 中途主动轮换 | 三层是否按预期保持、切换是否平滑 | 只盯出口 IP 不变更;以为换 IP 就能隔离账号 |
| 并发弹性 | 阶梯加压 → 退化 → 降载 → 恢复 | 退化拐点、超时/重试量、恢复耗时 | 只比峰值线程;容量不足误判成节点失效 |
| 可归因与可恢复 | 故障演练 + 变更/异常双时间线 | 分类准确度、主备有序性、能否复盘 | 异常一律换 IP;时间相近就当因果 |
跑法建议:先小样本、单变量,把四件事各自跑出一份可复盘的记录,再逐批放量。选型问题越具体——场景、测法、协作、成本都问成可验证的问题——结论才越站得住。"哪家好"这个问法,脱离了场景本来就没有答案。
写在最后
稳定性不是某个套餐参数,而是你这套业务在真实起伏下的一套可观测、可恢复的记录。四件事——可用率、会话保持、并发弹性、可归因与可恢复——本质是把"稳不稳"这个模糊感受,拆成四个能测、能记、能对照的问题。
我们在 90daili.com 整理这类接入问题时,也更愿意给可复核的测法,而不是一句"我们很稳定"。因为再好的出口,也经不起拿"能改 IP"当唯一验收;而一套讲得清、测得出、出问题能定位的用法,无论最后跑在哪家服务上,都让你心里有底。